KI-Sichtbarkeit
Als Anbieter in ChatGPT empfohlen werden
Wenn Ihre Käufer ChatGPT nach dem besten Anbieter fragen, nennt die Antwort meist nur eine Handvoll Firmen, und wer dort fehlt, kommt in…
Die 6 Bots von OpenAI und Anthropic steuern Sie in der robots.txt mit je einer eigenen Regelgruppe, und Training, Suche und Abruf auf Nutzerfrage lassen sich getrennt regeln, wobei Abrufe auf Nutzerauftrag die Regeln nicht immer beachten. Wer OAI-SearchBot sperrt, erscheint nicht in den Suchantworten von ChatGPT; wer Claude-SearchBot oder Claude-User sperrt, kann in Claude an Sichtbarkeit verlieren. Die Trainingsbots GPTBot und ClaudeBot sperren Sie getrennt davon.
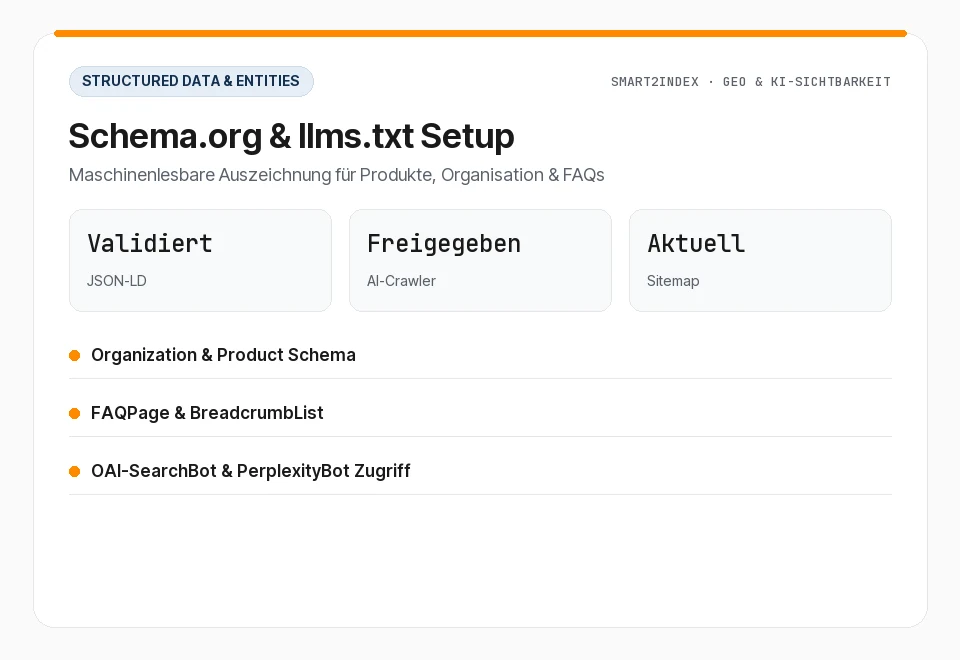
Wenn Ihre Käufer ChatGPT oder Perplexity nach Anbietern fragen, hängt es auch am Zugriff der KI-Bots, ob Ihre Seiten gelesen werden können. Das Thema betrifft Geschäftsführung, Marketing und Web-Verantwortliche im Mittelstand. Es geht um die Bots von OpenAI, Anthropic und Google, die Wahl zwischen Training sperren und Suche zulassen, die Einrichtung in der robots.txt und die Rolle der llms.txt.
Crawlen heißt: Ein Programm ruft Webseiten automatisch ab, folgt den Links darin und liest oder speichert den Inhalt. Suchmaschinen tun das seit Langem, und die KI-Anbieter betreiben eigene Bots dafür. Jeder Bot meldet sich beim Abruf mit einem Namen, dem User-Agent. Genau diesen Namen sprechen Sie in der robots.txt an.
Ein KI-Crawler dient je nach Anbieter einem von drei Zwecken:
Für Firmen, deren Käufer Anbieter vorab per ChatGPT oder Perplexity eingrenzen, betreffen Suche und Abruf die Antworten, die Käufer heute sehen. Das Training wirkt auf künftige Modelle.
Nicht alle Crawler führen JavaScript aus. Wichtige Inhalte gehören deshalb ins ausgelieferte HTML.
Für ChatGPT und Claude gibt es sechs Bots, die Sie einzeln ansprechen können, dazu bei Google den Token Google-Extended. Die Aufgaben beschreiben die Dokumentation von OpenAI und das Claude Help Center.
| Anbieter | Name in der robots.txt | Aufgabe | Wirkung einer Sperre |
|---|---|---|---|
| OpenAI | OAI-SearchBot | Suche in ChatGPT | Seite erscheint nicht in den Suchantworten von ChatGPT |
| OpenAI | GPTBot | Training | Inhalte sollen nicht für das Training genutzt werden |
| OpenAI | ChatGPT-User | Aktionen auf Nutzerauftrag | robots.txt-Regeln gelten möglicherweise nicht |
| Anthropic | Claude-SearchBot | Suchqualität | kann Sichtbarkeit in Suchantworten verringern |
| Anthropic | Claude-User | Abruf auf Nutzerfrage | kann Sichtbarkeit bei nutzergesteuerten Websuchen verringern |
| Anthropic | ClaudeBot | Training | künftige Inhalte sollen aus den Trainingsdaten ausgeschlossen werden |
| Google-Extended | Token für Gemini-Training und Fundierung | keine Wirkung auf Aufnahme und Ranking in der Google-Suche |
Googles eigene Crawler listet Google: Googlebot (Hauptcrawler für den Suchindex), Googlebot-Image, Googlebot-Video, Googlebot-News, Storebot-Google für Google Shopping, Google-InspectionTool für Testwerkzeuge wie die URL-Prüfung in der Search Console und GoogleOther als generischen Crawler mehrerer Produktteams. Google-Extended ist ein Token in der robots.txt, ein eigener Crawler steckt nicht dahinter.
Perplexity setzt zwei Bots ein, die in der Dokumentation von Perplexity beschrieben sind. PerplexityBot zeigt und verlinkt Websites in den Suchergebnissen von Perplexity und sammelt laut Anbieter keine Inhalte für das Training von Basismodellen. Perplexity-User ruft eine Seite ab, wenn ein Nutzer gerade eine Frage stellt, und ignoriert die robots.txt in der Regel, weil der Abruf auf Nutzerwunsch erfolgt. Wer in Antworten von Perplexity vorkommen will, lässt PerplexityBot zu.
Trainingsbots wie GPTBot und ClaudeBot können Sie sperren, ohne die Suchbots zu berühren. OpenAI behandelt die Einstellungen für OAI-SearchBot und GPTBot unabhängig voneinander, und Anthropic beschreibt bei ClaudeBot die Wirkung für künftige Inhalte Ihrer Website.
| Ihr Ziel | Zulassen | Sperren |
|---|---|---|
| In Antworten von ChatGPT und Claude vorkommen, Training ausschließen | OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot | GPTBot, ClaudeBot, auf Wunsch Google-Extended |
| In Antworten vorkommen, Training ist Ihnen gleich | alle sechs Bots, dazu PerplexityBot | keinen |
| Aus KI-Antworten und Training heraushalten | keinen | alle sechs Bots, dazu PerplexityBot und Google-Extended |
Die Suchbots zu sperren kann Sichtbarkeit kosten: Wer OAI-SearchBot sperrt, erscheint nicht in den Suchantworten von ChatGPT. Zulassen ist die Voraussetzung für eine Nennung und sichert sie nicht zu. Wie die Plattformen Anbieter auswählen, behandeln die Ratgeber zu ChatGPT und zu Claude und Gemini.
Bei ChatGPT-User gilt eine Einschränkung: Weil ein Nutzer den Abruf auslöst, greifen robots.txt-Regeln laut OpenAI möglicherweise nicht.
Sie steuern die Bots mit je einer Regelgruppe in der Datei robots.txt im obersten Verzeichnis Ihrer Domain. Für jede Subdomain brauchen Sie eine eigene Datei.
Beispiel für „Training sperren, Suche zulassen“: Regelgruppen für GPTBot und ClaudeBot mit „Disallow: /“, Regelgruppen für OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User und PerplexityBot mit „Allow: /“.
Unsere eigene robots.txt nennt unter anderem Googlebot, Bingbot, GPTBot, OAI-SearchBot, ChatGPT-User, PerplexityBot, ClaudeBot, Claude-SearchBot, Claude-User, Google-Extended und Applebot-Extended mit „Allow: /“ und sperrt nur Formular- und Dankesseiten.
Sie prüfen den Zugriff an vier Stellen: in der robots.txt, in den Server-Logs, im ausgelieferten HTML und für Google in der Search Console.
Fünf Fehler führen dazu, dass ein Bot trotz guter Absicht nicht durchkommt oder nichts Brauchbares findet.
| Fehler | Ursache | Lösung |
|---|---|---|
| Alle Bots gesperrt | „Disallow: /“ unter „User-agent: *“, etwa aus einer Testumgebung übernommen | Zeile entfernen und nach jedem Relaunch die Live-Datei öffnen |
| Bot kommt trotz „Allow: /“ nicht durch | Firewall- oder CDN-Regel blockiert unbekannte Bots | Server-Logs prüfen, Bot-Regeln der Firewall anpassen |
| Regelgruppe ohne Wirkung | Name falsch geschrieben oder Datei liegt auf der falschen Subdomain | Namen aus der Anbieter-Dokumentation übernehmen, je Subdomain eine Datei |
| Sperre per IP-Adresse | IP-Block statt Regel in der robots.txt | Laut Anthropic wirkt eine IP-Sperre womöglich nicht zuverlässig, weil der Bot die robots.txt dann nicht lesen kann; Regel in der robots.txt setzen |
| Wichtiger Text fehlt im Abruf | Inhalt wird erst per JavaScript nachgeladen | Wichtige Inhalte ins ausgelieferte HTML legen |
Beim letzten Fehler hilft keine Sonderversion nur für Bots: Besucher und Bots sollen dieselben Inhalte im ausgelieferten HTML finden. Wie technisches SEO und KI-Sichtbarkeit zusammenspielen, zeigt das Vorgehen im Ratgeber.
Die llms.txt ist eine Textdatei mit Angaben zu Anbieter, Leistungen und einer Seitenliste. Sie erlaubt und sperrt keinen Zugriff: Zugriffsregeln stehen allein in der robots.txt.
Unsere eigene llms.txt enthält diese Angaben. Sie ergänzt die robots.txt und ersetzt sie nicht: Erst legen Sie in der robots.txt fest, welche Bots Ihre Seiten abrufen dürfen, dann pflegen Sie die llms.txt als Wegweiser für die Inhalte, die gelesen werden sollen.
Eine Nennung in KI-Antworten sichert keine der beiden Dateien zu, auch Schema.org nicht. Die robots.txt entscheidet, was Bots lesen dürfen; ob eine Plattform Ihre Firma dann nennt, liegt bei der Plattform. Eine Schritt-für-Schritt-Anleitung steht im Ratgeber zur llms.txt für die Firmenwebsite.
Regeln braucht die robots.txt für die Plattformen, über die Ihre Käufer Anbieter suchen, meist ChatGPT, Claude, Perplexity, Gemini und die Google AI Overviews. ChatGPT und Claude sprechen Sie über die Bots von OpenAI und Anthropic an, Perplexity über PerplexityBot. Das Gemini-Training steuert der Token Google-Extended. Die Google AI Overviews gehören zur Google-Suche und damit zum Googlebot. Microsoft Copilot nutzt den Index von Bing, den der Bingbot aufbaut.
Nein, laut Google hat Google-Extended keinen Einfluss auf Aufnahme und Ranking in der Google-Suche, zu der die AI Overviews gehören. Der Token regelt nur, ob Inhalte für das Training von Gemini und die Fundierung in Gemini-Apps und Vertex AI genutzt werden. Wer eine Seite ganz aus der Google-Suche heraushalten will, braucht eine Regel für den Googlebot oder ein noindex und verliert damit auch die normalen Suchtreffer.
Nein, Sie müssen keinen Bot zulassen, aber gesperrte Suchbots können Sichtbarkeit kosten: Wer OAI-SearchBot sperrt, erscheint nicht in den Suchantworten von ChatGPT. Entscheiden Sie anhand Ihrer Käuferfragen. Lassen Sie messen, ob ChatGPT, Perplexity, Gemini, Claude und Google AI Overviews Ihre Firma bei diesen Fragen heute nennen, und sperren Sie danach nur, was Sie bewusst nicht wollen.
Bei Anthropic ja: Dort ist die nicht standardisierte Crawl-delay-Erweiterung unterstützt, etwa mit „User-agent: ClaudeBot“ und „Crawl-delay: 1“. Ob andere Bots die Angabe auswerten, steht in der Dokumentation des jeweiligen Anbieters. Prüfen Sie das dort, bevor Sie sich darauf verlassen, und beobachten Sie die Last danach in den Server-Logs.
Ja, statt „Disallow: /“ tragen Sie unter dem Namen des Bots nur den Pfad ein, zum Beispiel „Disallow: /danke“. So sperren wir in unserer eigenen robots.txt nur Formular- und Dankesseiten. Der Rest der Website bleibt für Such- und KI-Bots lesbar.
Wenn Ihre Käufer ChatGPT nach dem besten Anbieter fragen, nennt die Antwort meist nur eine Handvoll Firmen, und wer dort fehlt, kommt in…

Claude und Google Gemini können eine Firma aus zwei Quellen nennen: aus Wissen, das sie im Training gelernt haben, und aus Seiten, die sie…
Wer heute einen Anbieter sucht, bekommt von ChatGPT, Perplexity, Gemini, Claude oder Google AI Overviews oft einen fertigen Antworttext…
Ihre Käufer fragen ChatGPT, Perplexity oder Google AI nach dem besten Anbieter, und die Antwort nennt meist nur eine Handvoll Firmen.
Tragen Sie eine Käuferfrage und Ihre Domain ein. Wir fragen ChatGPT, Perplexity, Gemini, Claude und Google AI, und das Ergebnis kommt innerhalb eines Werktags per E-Mail. Kostenlosen KI-Check starten.